AI 악성코드 성숙도 격차
- 지금까지 관찰된 대부분의 "AI 악성코드"는 완전 자동화된 캠페인이 아니라 AI 악성코드 성숙도 모델(AIM3) 1~3단계(실험 단계부터 최적화 단계)에 속합니다.
- 현재 AI 는 기존 공격 기법을 강화하는 도구일 뿐, 근본적으로 새로운 공격 전술 TTPs 창출하는 원천은 아닙니다.
- 많은 "최초의 AI 악성코드" 발표는 자율성이 제한적이고 실제 영향이 불분명한, 좁은 범위의 연구 데모 또는 개념 증명(PoC)에 불과합니다.
- 공개된 리포팅 자료에 따르면, 피해자 호스트에서 자체 로컬 모델을 실행하는 진정한 임베디드형 BYOAI(Bring-Your-Own-AI) 악성코드의 확인된 사례는 없습니다.
- 방어자는 공상과학 소설 같은 시나리오에 과잉 반응하기보다는 합법적인 AI 서비스의 악용을 감시하고, 기존 제어를 강화하며, 위협을 AIM3 수준에 매핑하는 데 집중해야 합니다.
소개
생성형 AI (GenAI)과 대규모 언어 모델(LLM)은 통신부터 사이버 보안에 이르기까지 우리 사회의 모든 영역에 빠르게 통합되고 있습니다. 기업과 공급업체들은 이미 GenAI와 LLM을 활용하여 방어력을 강화하고 있습니다. 공격자들은 LLM(Local Load Management)을 주로 공격력 증강 수단으로 활용하고 있는데, 이는 기사 제목에서 흔히 암시되는 것처럼 한 번의 클릭으로 실행되는 슈퍼 멀웨어라기보다는 공격 범위를 넓히는 수단으로 보는 경향이 있습니다. 피싱 미끼부터 코드 생성 및 기본적인 오케스트레이션에 이르기까지, GenAI는 기술 장벽을 낮추고 익숙한 워크플로우를 가속화하는 것이지, 막을 수 없는 완전 자율 악성 소프트웨어를 새롭게 만들어내는 것이 아닙니다.
실제로 오늘날 대부분의 AI 악성코드 활동은 AI 성숙도의 초기 단계에 머물러 있으며, AI지원 코딩 및 기법, 지역화된 콘텐츠, 그리고 여전히 인간과 전통적인 도구에 크게 의존하는 실험적인 오케스트레이션에 초점을 맞추고 있습니다. 이러한 상황에서 일부 업체들은 좁은 범위의 개념 증명(PoC)이나 틈새 시장의 인시던트를 최초의 AI 공격이라고 서둘러 홍보하고 있습니다. 이 글에서는 과장된 주장을 바로잡고, AI 악성코드의 진정한 정의를 내리는 간단한 AI 악성코드 성숙도 모델(AIM3)을 소개합니다. 이 모델을 통해 최근 공개된 주장들을 구체적인 성숙도 수준과 연결하고, AI가 공격 경제에 실제로 어떤 변화를 가져오는지, 그리고 앞으로 더욱 정교하고 조직적인 위협에 어떻게 대비해야 하는지에 대한 현실적인 시각을 방어자에게 제공합니다.
“AI 악성코드”란 무엇을 의미하는가?
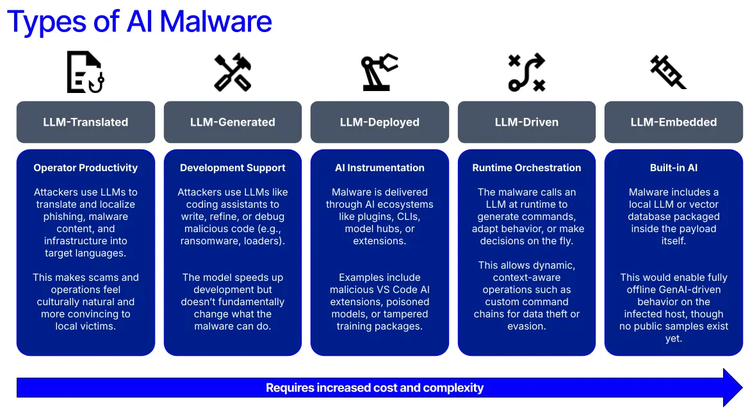
우리는 AI 멀웨어를 핵심 개발 또는 런타임 동작이 GenAI 또는 LLM에 의존하는 악의적이거나 공격적인 소프트웨어로 정의합니다. 악성 소프트웨어는 LLM을 사용하여 런타임에 명령을 생성하거나 선택하고, 실행 계획을 위해 파일이나 환경 원격 측정 데이터를 검사하거나, 단계별 사람 입력 없이 공격 과정의 일부를 조율할 수 있습니다. 이러한 설명에 부합하는 AI 악성 소프트웨어는 LLM 번역형, LLM 생성형, LLM 배포형, LLM 구동형, LLM 내장형의 다섯 가지 유형이 있습니다.
AIM3를 사용하여 AI 악성코드 성숙도 측정
지난 몇 년간 다양한 유형의 AI 악성코드가 관찰되었음에도 불구하고, 현재 AI 악성코드의 성숙도 수준에 대해서는 의견 일치가 이루어지지 않고 있습니다. MITRE의 "AI 성숙도 모델 "과 같은 사이버 보안 도입 성숙도 모델은 존재하지만, AI 기반 악성코드 자체의 정교함과 조직에 미치는 운영 위험을 직접 측정하는 공격자 중심 모델은 없습니다. 이러한 격차를 해소하기 위해 Recorded Future는 AI 위협의 정교함 수준을 파악하고 탐지 및 관리 노력을 집중해야 할 부분을 식별하는 데 도움이 되는 5단계 AIM3를 제안합니다. AIM3는 방어자가 실제 AI 기반 위협과 마케팅성 허위 정보를 구분할 수 있는 수단을 제공합니다.
Recorded Future의 AI 악성코드 성숙도 모델(AIM3)의 단계
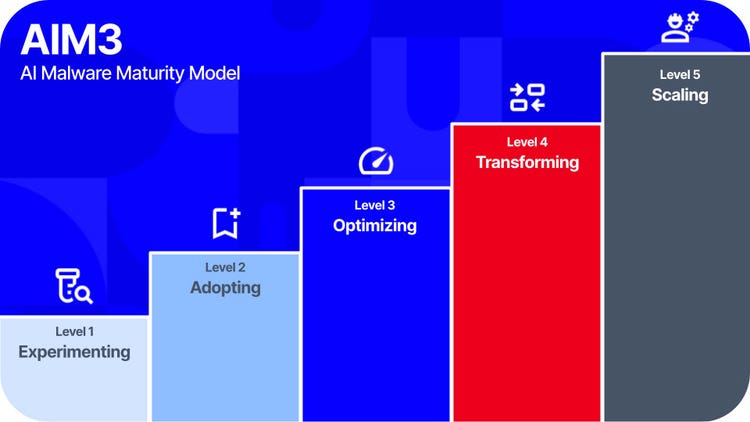
1단계 - 실험하기:
공격자, 연구원, 그리고 학계는 기본적인 방법을 사용하여 GenAI를 활용하는 프로토타입, 모의 예제, 그리고 개념 증명(PoC)을 만들고 있습니다. 현재 단계에서는 개인들이 GenAI와 LLM을 악의적인 용도로 활용할 가능성을 탐색하는 수준에 그치고 있으며, 실제로 이를 심각하게 활용하는 단계는 아닙니다.
2단계 - 입양:
위협 행위자들은 피싱 이메일 작성, 공격 대상 조사, 코드 개발과 같은 익숙한 워크플로에 GenAI를 통합합니다. 핵심 운영 업무는 기존 방식대로 유지되지만, 전통적인 기술을 재창조하지 않고도 하위 단계 업무를 자동화하고 지원하는 데 중점을 둡니다.
3단계 - 최적화:
공격자들은 호스트 내에서 또는 API를 통해 GenAI를 활용하여 시스템 내부를 분석하고, 명령어를 생성하고, 거의 실시간으로 코드를 수정하는 등 AI를 공격 사슬에 통합하기 시작했습니다. 이는 맞춤형 GenAI 사용에서 GenAI를 공격 사슬의 통합된 부분으로 취급하는 방향으로 초점이 전환된 것을 의미합니다.
4단계 - 변형:
이 단계에서는 AI 기반 공격 프레임워크가 등장하며, 이는 다단계 계획 수립 및 도구 사용을 인간 참여형(HITL) 접근 방식과 결합합니다. 이는 기존 전략에 인공지능(GenAI)을 덧붙이는 방식이 아니라 에이전트 기반 패턴을 활용하여 인공지능 우선 위협 대응 작전을 의도적으로 초기 단계에서 시도한 사례입니다.
레벨 5 - 스케일링:
위협 행위자들은 인간의 감독 없이 캠페인을 처음부터 끝까지 관리하는 에이전트 시스템을 구축하고 있습니다. 자동화된 의사 결정 시스템은 운영의 계획, 실행 및 유지 단계에 걸쳐 대규모로 구현됩니다. 이러한 수준의 정교함은 현재 실험이 나아가고 있는 방향의 GenAI 능력의 상한선을 나타냅니다.
AIM3가 정의되었으므로 이제 공개된 정보와 연구 자료에서 실제로 보고된 내용을 살펴볼 수 있습니다.
야생에서 우리가 보는 것
2023년부터 2024년까지 (초기 실험)
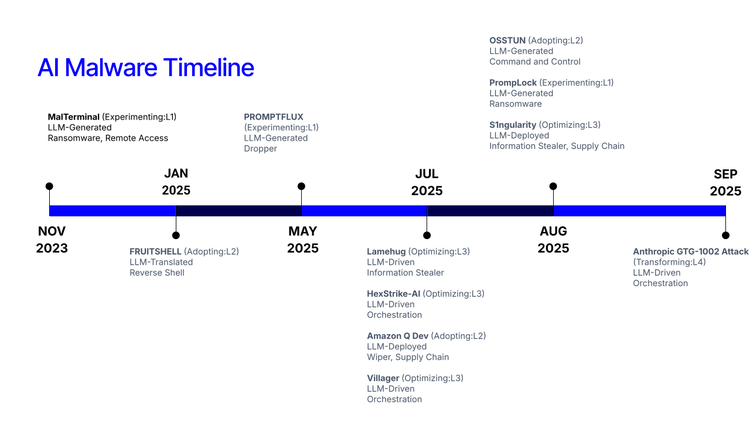
- 말단부 (AIM3: 레벨 1 - 실험) 은 LLM 기반 랜섬웨어 및 원격 접속 도구(RAT) 개념을 보여주는 초기 악성코드 프로토타입으로, 사람의 입력에 따라 AI가 주로 코드 생성에 사용됩니다. 이 샘플은 악성 여부를 평가하고 결과 페이로드에 대한 악성코드 분석 보고서를 생성하는 내장 기능으로 미루어 보아 거의 확실히 악의적이지 않은 실험용이었을 것입니다.
2025년 초중반 (AI를 유발하는 악성 소프트웨어 출현)
- 과일 껍질 (AIM3: 레벨 2 - 도입) 은 침투 테스터를 위한 PowerShell 리버스 셸 스크립트로, LLM 기반 분석을 우회하기 위한 하드코딩된 프롬프트 지침을 포함하고 있습니다. 개발 과정에서 LLM에 대한 인식을 높이면 이 예시는 채택 단계에 해당합니다.
- PROMPTFLUX (AIM3: 레벨 1 - 실험) 은 VBScript로 작성된 악성코드 드로퍼로, Google Gemini를 사용하여 자체 소스 코드를 재작성하고 새로운 페이로드를 실행하여 지속성을 확보합니다. 구글이 실험적이라고 표시한 이 샘플은 AI 사용하여 벌레 모양의 특징을 구현한 최초의 사례 중 하나입니다.
- 라메허그 (Lamehug ) PROMPTSTEAL (AIM3: 레벨 3 - 최적화) 은 HuggingFace API를 호출하여 정찰 명령을 생성하는 LLM 기반 정보 탈취 샘플입니다. CERT-UA 가 발견한 Lamehug는 APT28의 소행으로 추정되며, 이는 국가 지원 사이버 작전에 AI 악성 소프트웨어가 사용된 첫 사례일 가능성이 있습니다. APT28이 공격 과정에서 AI를 활용하는 것은 이 문제를 최적화 단계로 끌어올립니다.
- HexStrike-AI (AIM3: 레벨 3 - 최적화) 는 기존 레드팀 도구와 연결된 모델 컨텍스트 프로토콜(MCP) 기반의 오픈 소스 침투 테스트 프레임워크입니다. GenAI를 활용하여 nmap과 같은 기존 도구를 구동하기 위해 여러 AI 에이전트를 배포하는 최초의 공개 레드팀 프레임워크 중 하나입니다. LLM 호출 및 에이전트 사용으로 인해 이는 최적화 수준에 해당합니다.
- 아마존 Q Dev (AIM3: 레벨 2 - 도입) Visual Studio Code 확장 프로그램 버전 1.84.0에는 로컬 및 클라우드 환경을 삭제하도록 지시하는 악성 프롬프트 삽입 명령이 포함되어 있었습니다. 구문 오류로 인해 코드가 제대로 실행되지 않았음에도 불구하고, 이 예제는 내장된 악성 코드로 인해 CVE (CVE-2025-8217)로 분류되었습니다. 이는 LLM이 인지하고는 있지만 구현 방식에 오류가 있어 도입 단계에 해당합니다.
- 사이버스파이크의 마을 주민 (AIM3: 레벨 3 - 최적화) 는 중국에 기반을 둔 레드팀 프로젝트인 사이버스파이크(Cyberspike)에서 개발한 AI 기반 침투 테스트 프레임워크입니다. 이 소프트웨어는 DeepseekAI와 Kali Linux를 통합하여 레드팀 워크플로우를 자동화함으로써 Cobalt Strike의 AI 중심 후속 제품이 되려고 합니다. HexStrike-AI와 마찬가지로 Villager는 운영 과정에서 AsyncRAT(원격 접속 도구) 및 Mimikatz(자격 증명 수집 도구)를 포함한 기존 레드팀 도구를 사용합니다. LLM 호출 및 에이전트 사용으로 인해 이 단계는 최적화 단계에 놓이게 됩니다.
2025년 후반 (AI 기반 구현이 성공을 거둘 것)
- OSSTUN (AIM3: 레벨 2 - 도입) 은 구글이 국가 지원 위협 행위자인 RedGolf(APT41로도 알려짐)가 Gemini를 사용하여 다른 도구들과 함께 개발하고 있는 것을 관찰한 명령 및 제어(C2) 프레임워크입니다. RedGolf LLM은 개발 과정에서 이 사례를 인식하여 채택 단계에 포함시켰습니다.
- PromptLock (AIM3: 레벨 1 - 실험)은 로컬 파일을 이해하고 맞춤형 랜섬웨어 노트를 생성하기 위해 LLM을 사용하는 최초의 AI 기반 랜섬웨어로 알려져 있습니다. 발견 직후, 이는 학술 논문을 위한 개념 증명(PoC) 샘플로 확인되어 실험 단계에 놓이게 되었습니다.
- S1ngularity 또는 QUIETVAULT (AIM3: 레벨 3 - 최적화) 는 널리 사용되는 패키지 시스템인 Nx의 악성 버전 모음으로, 노드.js npm 레지스트리에 게시 되었습니다. 해당 패키지는 AI 활용하여 취약한 GitHub Actions를 악용하고, 증거를 탈취한 후 피해자의 GitHub 계정 내 노출된 저장소로 데이터를 유출했습니다. 공격 과정에서 LLM을 성공적으로 사용한 것은 이 사건을 최적화 단계로 분류하게 합니다.
- 인류 (AIM3: 레벨 4 - 변혁)은 최초로 보고된 AI가 조직한 사이버 스파이 공격이라고 주장하는 사례를 상세히 설명하고 이를 저지했습니다. 이 경우, 앤트로픽은 이 활동이 클로드 코드(Claude Code)를 위반한 중국 국가 기관의 소행임을 밝혀낼 수 있었습니다. 그 후, 해당 위협 행위자 클로드 코드의 에이전트 기능을 활용하여 사이버 킬 체인 전반에 걸쳐 다양한 조치를 취했으며, 이는 AIM3 변환 레벨에서 관찰된 유일한 사례입니다. 하지만 앤트로픽의 보고서는 모든 것이 완벽하게 조직적으로 이루어졌다는 주장에 대해 비판을 받았습니다. 보고서에 따르면 캠페인의 일부 의사 결정 단계에서는 여전히 10%의 인간 개입이 필요했으며, 이로 인해 AIM3 확장 수준에 도달하지 못했다고 합니다.
과장 vs. 현실 - 무엇이 진실이고 무엇이 과장된 것일까?
지난 몇 년간 "AI 악성코드" 관련 뉴스가 쏟아지면서 몇 가지 분명한 패턴이 나타났습니다. 대부분의 공공 활동은 마케팅에서 흔히 암시하는 할리우드식의 완전 자율적인 위협과는 거리가 멀다.
실제 활동이 이루어지는 곳 (AIM3 레벨 1~3)
AIM3에 매핑해 보면 상황이 명확해집니다. 대다수의 사례는 1~3단계(실험부터 최적화까지)에 속하며, 논란이 있는 4단계 사례가 하나 있고, 검증된 5단계 활동은 없습니다. PromptLock, PROMPTFLUX, MalTerminal과 같은 패밀리는 실제 존재하는 악성코드라기보다는 개념 증명(PoC) 연습에 더 가까워 보입니다. 인류 중심적 사례는 4단계(변혁적) 성숙도의 유일하고도 논쟁적인 사례이지만, 이 초기 사례조차도 완전히 자율적이지는 않았습니다.
이러한 관점에서 보면 몇 가지 사실이 명확해집니다. 완전 내장형 모델은 여전히 이론적인 단계에 머물러 있고, 최초의 AI 악성코드라고 주장하는 많은 사례는 근거가 미약하거나 실험적인 증거에 기반하고 있으며, 진정으로 주목해야 할 전환점은 무차별적인 자율성이 아니라 꾸준히 발전하는 AI 기반 오케스트레이션이라는 점입니다. 즉, 데이터는 과장된 소문이 현실을 앞서가는 부분과 공격자의 역량에 있어 다음으로 진정한 변화가 나타날 가능성이 높은 부분을 알려줍니다.
BYOAI와 임베디드 모델: 아직 실전에서는 가설 단계에 머물러 있다
공개된 AI 악성코드 구현 사례의 대부분은 로컬에 내장된 모델이 아닌 클라우드 또는 원격 LLM을 호출합니다. Lamehug와 같은 악의적인 사례에서도 가족 구성원들은 런타임에 LLM 호출을 위해 HuggingFace API와 같은 원격 서비스를 사용합니다. 경우에 따라 페이로드는 로컬에서 사용 가능한 LLM 서비스를 이용하여 해당 서비스가 페이로드를 대신하여 원격 호출을 수행할 수 있습니다. 그러나 현재까지 관찰된 샘플 중에는 BYOAI(Bring Your Own AI) 기능을 지원하는 샘플은 없습니다. 이는 사실상 LLM-Embedded 범주에 해당합니다. 즉, 호스트에서 로컬로 실행될 자체 모델을 포함하는 AI 악성 소프트웨어입니다.
최초의 AI 악성코드 문제
2025년 7월부터 11월 사이에 Malterminal, Lamehug, PromptLock, Anthropic 사이버 공격과 관련된 네 건의 "최초" 보고서가 발표되었으며, 이는 AI 악성코드 환경의 다양한 측면을 다루고 있습니다. 리포팅 이후, 이러한 주장들 중 상당수는 연구계에서 학문적이고 실험적이거나 기대에 미치지 못하는 것으로 평가받으며 면밀한 검토를 받았습니다. 이러한 사례들은 스크립팅 및 자동화의 점진적인 발전을 명확히 보여주지만, 공급업체들은 현장에서 독립적으로 검증할 수 있는 것보다 더 강력한 주장을 서둘러 내놓는 경향이 있습니다.
CISO 여러분께 드리는 말씀
AI 악성코드로부터 자신을 보호할 수 있는 방법을 찾고자 하는 CISO는 다음 세 가지 질문에 대한 답을 찾는 것부터 시작해야 합니다.
- 귀사는 적절한 AI 거버넌스 체계를 갖추고 있습니까?
- 여러분의 환경에서 AI의 악용 사례를 찾아낼 수 있습니까?
- 귀사의 방어 체계는 AI 기반 도구에 효과적으로 대응할 수 있습니까?
전망
AI 악성코드는 아직 초기 단계에 있으며, 주로 AIM3 프레임워크의 실험 단계에서 최적화 단계에 머물러 있습니다. 오늘날 우리가 목격하는 것은 전통적인 전술, TTPs 모방하는 AI기반 공격 기법입니다. 이는 AI 도입 증가의 자연스러운 결과이며, 다른 여러 산업에서도 이러한 현상이 관찰되고 있습니다.
그렇지만 AI 도입이 나아가고 있는 방향은 분명합니다. 단순한 AI 생성 콘텐츠에서 AI를 이용한 악성코드 및 레드팀 운영 프레임워크로의 발전은 더욱 강력하고 자율적인 운영이 다가오고 있음을 보여주는 신호입니다. 논란이 되고 있는 인간 활동으로 인한 생태계 파괴는 이러한 현상의 초기 사례 중 하나이며, 생태계 옹호자들에게 조기 경고 신호 역할을 합니다.
모든 길은 AI 오케스트레이션으로 통한다.
AI 활동의 궤적은 분명히 AI 오케스트레이션으로 향하고 있지만, 아직 완전한 규모의 AI 운영 단계에는 이르지 못했습니다. HexStrike-AI나 CyberSpike의 Villager와 같은 프레임워크는 오늘날에는 여전히 틈새시장이지만, 오케스트레이션과 AI 기반 도구 사용이 일반화되는 공격자 플레이북을 보여줍니다. AI 악성코드 관찰의 타임라인은 명확한 발전 과정을 보여줍니다. 단순한 AI 생성 코드에서 시작하여 호스트 내 명령 생성 및 오케스트레이션으로 나아가고, 최종적으로는 에이전트 기반의 다단계 작업으로 정점에 달합니다. 이러한 프레임워크가 계속 발전한다면 시간이 지남에 따라 인간의 개입이 점점 줄어들 가능성이 높습니다.
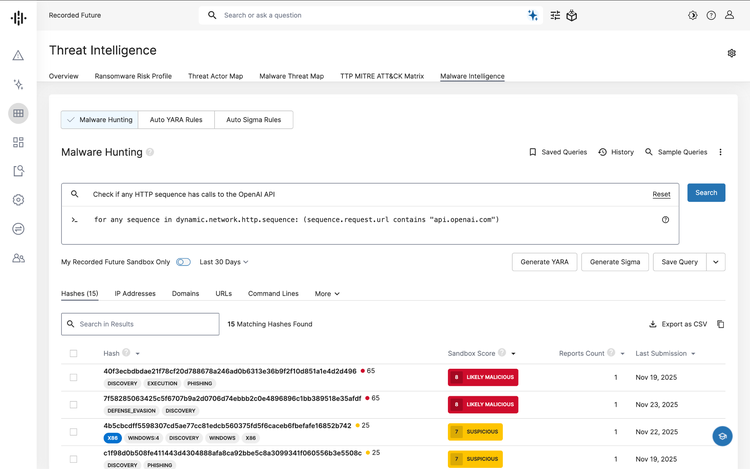
Recorded Future가 AI 성숙도 단계에 따른 악성코드 추적에 어떻게 도움을 줄 수 있는지 알아보려면 LAMEHUG 악성코드(AIM3) 조사에 대한 3분짜리 영상을 시청하세요.
방어 시설
- 방어자는 GenAI 및 LLM 사용(내부 및 외부 모두)에 대한 중앙집중식 모니터링 및 로깅을 구축하여 환경 내에서 GenAI가 어떻게 활용되고 있는지 파악하고 이상 징후를 감지해야 합니다.
- 정책 기반 액세스를 승인된 LLM 제공업체에 적용하고 LLM에서 생성, 배포 또는 LLM을 통해 악용될 수 있는 승인되지 않은 서비스, 플러그인, 도구 및 모델 허브를 차단하여 공격 표면을 줄이십시오.
- AI 기존 위협 행위자 기법에 사용되고 있다고 가정하고 기본적인 통제를 강화하면, 공격자가 GenAI를 이용해 더 빠르게 움직이더라도 기존 방어 체계에 의해 탐지될 수 있습니다.
- Recorded Future Malware Intelligence를 사용 하면 AI 기반 위협에 대한 현재 위협 환경을 모니터링할 수 있습니다. Recorded Future 사용자는 AI 도구에서 사용되는 악성코드나 비정상적인 패턴을 검색하여 잠재적 위험을 평가할 수 있습니다.
"AI 과대광고 vs. 현실" 시리즈에서 더 자세한 내용을 읽어보세요.